KI-Cluster bauen oder High-Memory-Mini-PC kaufen?
Sie betreiben bereits einen KI-Mini-PC mit lokaler KI. Er funktioniert gut — aber nun möchten Sie einen zweiten hinzufügen.
Was genau bringt das?
- Können beide Mini-PCs dadurch mehr KI-Workloads gleichzeitig bewältigen? Ja.
- Können verschiedene KI-Agenten auf getrennten Knoten laufen? Ja.
- Können zwei 128-GB-Mini-PCs sich wie ein einziger 256-GB-Rechner verhalten? Nein.
Der Unterschied wird in einem einfachen Vergleich deutlicher:
| Konzept | Zwei 128-GB-Mini-PCs |
|---|---|
| Gesamter physischer Speicher | 256 GB |
| Speicher pro Knoten | 128 GB |
| Speicher direkt für ein Modell verfügbar | In der Regel keine 256 GB |
| Speicherbandbreite | Addiert sich nicht einfach |
| Netzwerkbandbreite | Separat von der Speicherbandbreite |
Diese Unterscheidung ist wichtig, denn die gesamte Speicherkapazität entspricht nicht automatisch dem Speicher, der einem einzelnen Workload zur Verfügung steht. Zwei 128-GB-Mini-PCs enthalten zusammen 256 GB physischen Speicher, aber dieser ist auf zwei getrennte Systeme verteilt. Ob ein einzelner lokaler LLM-Speicher von beiden Knoten genutzt werden kann, hängt vom Framework für verteilte Inferenz ab und davon, wie das Modell partitioniert wird.
Ein Mini-PC-Cluster kann für lokale KI äußerst nützlich sein, aber nur, wenn die Cluster-Architektur zum Problem passt, das Sie lösen möchten. In der Praxis gibt es zwei grundlegend verschiedene Gründe, mehrere KI-Knoten zu verbinden:
Mehr unabhängige KI-Workloads gleichzeitig ausführen oder einen Workload über mehrere Knoten aufteilen.
Diese Ansätze haben sehr unterschiedliche Anforderungen an Speicher, Netzwerk und Software.
Der beste Ausgangspunkt ist daher nicht die Cluster-Hardware, sondern der tatsächliche Engpass.

Was bringt das Hinzufügen eines zweiten Mini-PCs tatsächlich?
Bevor Sie einen weiteren Knoten kaufen, identifizieren Sie, was Sie ausbremst.
Die nützliche Frage ist nicht:
Können Mini-PCs geclustert werden?
Ja, das können sie.
Die nützliche Frage ist:
Welche Aufgabe soll der zweite Knoten übernehmen?
Können mehrere Mini-PCs gemeinsam KI ausführen?
Ja, aber es gibt zwei grundlegend verschiedene Vorgehensweisen.
Ein KI-Cluster kann entweder unabhängige Workloads zwischen Knoten verteilen oder verteilte Software einsetzen, sodass mehrere Knoten am selben Workload teilnehmen.
Diese sollten nicht als dieselbe Architektur betrachtet werden.
Workload-Routing
Im einfacheren Setup bleibt jeder Mini-PC ein unabhängiger KI-Knoten.
Beispiel:
- Knoten A
- Großes LLM
- Knoten B
- Codierungsmodell
- Knoten C
- Embeddings oder ein anderer KI-Agent
Wenn eine Anfrage eingeht, entscheidet Routing-Software, welcher Knoten sie bearbeiten soll.
Die gesamte Inferenz-Anfrage läuft weiterhin auf einem Knoten.
NVIDIA Personal AI Router (PAIR) arbeitet nach diesem Grundprinzip. Unabhängige Inferenz-Anfragen können an geeignete Knoten geroutet werden, basierend auf Faktoren wie Modellverfügbarkeit und aktueller Auslastung. Die NVIDIA-Entwicklerdokumentation beschreibt ausführlicher, wie PAIR geeignete Knoten für Anfragen auswählt.
Dies ist nützlich, wenn Ihr Engpass die Nebenläufigkeit (Concurrency) ist.
Wenn mehrere KI-Agenten alle auf dieselbe Inferenz-Engine warten, kann ein zusätzlicher Knoten Warteschlangen reduzieren, indem unabhängige Anfragen parallel ausgeführt werden.
Dabei werden zwei Knoten jedoch nicht zu einem gemeinsamen Beschleuniger.
Fasst ein Mini-PC-Cluster den RAM mehrerer Rechner zusammen?
Dies ist eine der wichtigsten Unterscheidungen beim Aufbau eines LLM-Clusters — besonders wenn Sie einen Mini-PC für lokale LLMs einsetzen und prüfen, ob ein zweiter Knoten den nutzbaren Speicher erhöht.
Nehmen wir an, Sie haben:
- Knoten A: 128 GB
- Knoten B: 128 GB
Zusammen ergeben sich zwar 256 GB physischer Speicher, aber daraus wird kein einzelnes 256-GB-Speichersystem. Jeder Knoten behält seinen eigenen Speicher.

In einem Cluster mit Workload-Routing ist dies unkompliziert.
Wenn Knoten A eine Anfrage erhält, muss das Modell in den auf Knoten A verfügbaren Speicher passen. Es kann nicht einfach ungenutzten Speicher von Knoten B ausleihen.
Routing-Systeme wie NVIDIA PAIR verwandeln den Speicher mehrerer Knoten nicht in einen gemeinsamen Pool.
Verteilte Inferenz ist anders. Bei der verteilten KI können einige Frameworks verschiedene Teile eines Modells oder einer Berechnung auf mehrere Knoten verteilen. Das kann es ermöglichen, dass ein Modell mehr Gesamtspeicher nutzt, als ein einzelner Knoten bereitstellt.
Aber auch dann gilt:
2 × 128 GB ist nicht gleichbedeutend mit einem nativen 256-GB-Speichersystem.
Die Knoten müssen über das Netzwerk kommunizieren, und diese Kommunikation bringt Overhead mit sich.
Wichtig: Ein Mini-PC-Cluster fasst den Speicher zwischen Knoten nicht automatisch zusammen. Workload-Routing-Systeme halten den Speicher jedes Knotens getrennt. Frameworks für verteilte Inferenz können Modelldaten über Knoten verteilen, aber dies fügt Netzwerk-Overhead hinzu und ist nicht dasselbe wie ein einzelnes High-Memory-System. Wenn Ihr Hauptziel darin besteht, ein sehr großes Modell auszuführen, ist ein einzelner High-Memory-Knoten wie der M1A PRO+ mit 128 GB Unified Memory in der Regel einfacher und vermeidet den Netzwerk-Overhead der verteilten Inferenz.
Zwei Arten von lokalem KI-Cluster: Workload-Routing vs. verteilte Inferenz
| Konzept | Workload-Routing | Verteilte Inferenz |
|---|---|---|
| Hauptzweck | Mehr unabhängige Workloads ausführen | Einen Workload über Knoten verteilen |
| Modellstandort | Ein Knoten | Mehrere Knoten |
| Speicher | Getrennt | Kann verteilt werden |
| Netzwerkabhängigkeit | Niedrig | Hoch |
| 2,5-GbE | Oft ausreichend | Kann zum Engpass werden |
| Einrichtungsaufwand | Niedriger | Höher |
| Optimal für | Mehrere Agenten oder Nutzer |
Modelle zu groß für einen Knoten |
Der Unterschied lässt sich nebeneinander besser erkennen.
Die Tabelle macht deutlich, dass verteilte KI kein automatischer Vorteil eines Clusters ist, sondern eine eigene Architektur mit eigenen Anforderungen.
Dies erklärt, warum das Hinzufügen eines weiteren Mini-PCs einen KI-Workflow drastisch verbessern und einen anderen kaum verändern kann.
Wenn zehn unabhängige Anfragen warten, kann ein zweiter Knoten nützliche Kapazität hinzufügen.
Wenn ein Nutzer mit einem Modell chattet, das bequem auf einen Knoten passt, trägt ein zweiter Knoten möglicherweise kaum bei, sofern das Framework den Workload nicht tatsächlich aufteilen kann.
Können Sie einen lokalen LLM-Cluster über mehrere PCs aufbauen?
Ja.
Verteilte Frameworks können mehrere Knoten an einem Modell-Workload beteiligen.
Ein Beispiel ist das RPC-Backend in Llama.cpp, das Remote-Geräte freigeben und Teile der Modellberechnung über das Netzwerk auslagern kann. Das llama.cpp-Projekt dokumentiert das RPC-Backend und seine Anforderungen ausführlicher.
Das macht es technisch möglich, ein Modell über mehrere Systeme auszuführen, statt den gesamten Workload auf einem Knoten zu behalten.
Aber es gibt einen wichtigen Kompromiss:
Verteilte Inferenz kann es ermöglichen, Modelle zu verarbeiten, die den Speicher eines einzelnen Knotens überschreiten — gleichzeitig kann sie jedoch die Latenz erhöhen.
Auch mit schnellem Netzwerk wird das Aufteilen eines lokalen LLMs über mehrere Knoten in der Regel mehr Kommunikations-Overhead mit sich bringen als die Ausführung desselben Modells vollständig auf einem ausreichend großen High-Memory-Knoten.
Das bedeutet, dass ein verteilter Aufbau es Ihnen ermöglichen kann, ein Modell auszuführen, das sonst nicht passen würde, während er dennoch eine schlechtere Time to First Token (TTFT) oder Token-Latenz liefern kann als eine Einzelknoten-Konfiguration.
Es gibt also eigentlich zwei Fragen:
Können mehrere Knoten das Modell ausführen?
und:
Wird das Ergebnis schnell genug für Ihre beabsichtigte Nutzung sein?
Das sind nicht dieselben Dinge.
Für Batch-Verarbeitung, Experimente oder langlaufende Jobs kann eine höhere Latenz akzeptabel sein.
Für einen interaktiven lokalen Assistenten kann sie deutlich spürbar sein.
KI-Cluster-Netzwerk: Ist 2,5-Gbit-Ethernet schnell genug?
Es gibt keine universelle Netzwerkanforderung für einen KI-Mini-PC-Cluster.
Es hängt davon ab, was tatsächlich über das Netzwerk übertragen wird.

Workload-Routing
Wenn Knoten A ein Modell lokal ausführt und Knoten B ein anderes, transportiert das Netzwerk hauptsächlich:
- Prompts
- Antworten
- API-Traffic
- Knotenstatus
- Routing-Informationen
Das Modell selbst muss nicht ständig zwischen Knoten verschoben werden.
Für diese Art von Mini-PC-KI-Cluster kann 2,5-Gbit-Ethernet ein praktischer Ausgangspunkt sein.
Verteilte Inferenz
Die Anforderungen ändern sich, wenn zwei oder mehr Knoten an derselben Inferenz-Anfrage teilnehmen.
Nun müssen möglicherweise Zwischendaten zwischen Knoten übertragen werden, während die Inferenz läuft.
Netzwerkbandbreite und Latenz können daher Teil des Leistungsengpasses werden.
Eine einfache Überlegung zum KI-Cluster-Netzwerk:
Statt zu fragen:
Reicht 2,5-GbE für einen KI-Cluster?
Fragen Sie:
Wie viele Daten müssen zwischen meinen KI-Knoten übertragen werden, während der Workload läuft?
Beim Workload-Routing kann der Datenverkehr vergleichsweise gering sein.
Bei der verteilten Inferenz kann es deutlich mehr sein.
Ein High-Memory-Mini-PC oder zwei Cluster-Knoten?
Dies ist oft die nützlichere Kaufentscheidung.
Nehmen wir an, Ihre Wahl besteht zwischen:
einem Knoten mit ausreichend Speicher, um das Modell lokal auszuführen
oder
zwei kleineren Knoten mit mehr kombinierten Ressourcen
Wenn die Hauptanforderung ein großes lokales LLM ist, ist der High-Memory-Einzelknoten in der Regel einfacher.
Sie vermeiden:
- Netzwerk-Overhead
- Modellpartitionierung
- zusätzliche OS-Wartung
- ein weiteres Netzteil
- einen weiteren Fehlerpunkt
- Konfiguration des verteilten Frameworks
Ein LLM-Cluster wird attraktiver, wenn sich ein Workload tatsächlich sinnvoll auf mehrere Knoten verteilen lässt.
Beispielsweise könnten Sie wollen:
Knoten A
→ Haupt-LLM
Knoten B
→ Embeddings, Bildgenerierung, Codierungsmodell oder einen anderen Agenten
In diesem Fall löst der zweite Knoten ein echtes Ressourcen-Konkurrenzproblem.
Eine nützliche Regel:
Skalieren Sie nach oben, wenn ein Workload mehr Ressourcen benötigt.
Skalieren Sie nach außen, wenn Sie mehr unabhängige Arbeit ausführen möchten.
Verteilte Inferenz ist die Ausnahme, die zwischen diesen beiden Ideen steht: Sie skalieren nach außen, weil ein einzelner Workload nicht mehr auf einen Knoten passt.
Für weitere Kontext zur Wahl zwischen einem einzelnen High-Memory-Knoten und mehreren Systemen erklärt der Strix Halo-Speichervergleich, wie viel RAM für LLM verschiedene Modellgrößen tatsächlich benötigen.
Was macht einen guten KI-Knoten aus?
Die teuerste CPU ist nicht automatisch die beste Cluster-Wahl.
Entscheidend ist vielmehr, wie gut das gesamte System als KI-Knoten geeignet ist.
Deshalb reichen TOPS allein nicht aus, um zu beurteilen, ob ein Mini-PC einen guten Cluster-Knoten darstellt.
Ein Knoten kann starke NPU-Spezifikationen haben, aber dennoch ungeeignet sein, wenn Ihre Software primär auf CUDA angewiesen ist.
Ebenso kann ein weniger leistungsstarker Knoten dennoch wertvoll sein, wenn er kleinere oder Hintergrund-Workloads vom Haupt-Inferenzknoten übernimmt.
Brauchen KI-Cluster-Knoten dieselbe Hardware?
Nein.
Für Workload-Routing kann unterschiedliche Hardware sogar nützlich sein.
Dies ist ein heterogener Cluster.
Sie könnten gezielt verwenden:
Jeder Knoten übernimmt die Aufgabe, die zu seiner Hardware passt.
Das kann nützlicher sein, als mehrere identische Systeme zu kaufen.
Heterogene Cluster haben jedoch auch eine Einschränkung.
Sie funktionieren gut, wenn Workloads unabhängig geroutet werden können, aber unterschiedliche Hardware kann zu Last-Imbalance führen, wenn mehrere verschiedene Knoten bei einer verteilten Inferenz-Aufgabe zusammenarbeiten sollen.
Ein schnellerer Knoten könnte auf einen langsameren warten, während Unterschiede in GPU-Architektur, verfügbarem Speicher und Framework-Unterstützung die Workload-Aufteilung erschweren können.
Hardware-Vielfalt ist also in der Regel eine Stärke beim Workload-Routing und eine mögliche Komplikation bei der verteilten Inferenz.
Ein praktischer Drei-Knoten-KI-Cluster für lokale KI
Nun werden die Hardware-Entscheidungen leichter verständlich.
Anstatt drei Mini-PCs vom schnellsten zum langsamsten zu rangieren, weisen Sie jedem eine spezifische Rolle zu.

ACEMAGIC M1A PRO+ 395 — High-Memory-Knoten
Der M1A PRO+ 395 ist die natürliche Wahl für speicherintensive lokale KI-Workloads.
Seine clusterrelevanten Merkmale umfassen:
- Ryzen AI Max+ 395
- Radeon 8060S
- 128 GB LPDDR5X-Speicher
- Dual 2,5-Gbit-Ethernet
- mehrere lokale Speicheroptionen
Als 128-GB-RAM-Mini-PC ist der M1A PRO+ 395 darauf ausgelegt, auch anspruchsvolle LLM-Inferenz komplett auf einem Knoten auszuführen.
Das entscheidende Merkmal hier ist nicht einfach die Prozessorleistung.
Es ist die Fähigkeit, einen relativ großen Workload vollständig auf einem Knoten zu halten.
In einem Cluster könnte der M1A PRO+ daher als primärer High-Memory-Inferenzknoten fungieren.
Beispiel:
M1A PRO+
→ Haupt-lokales LLM
während andere Knoten Aufgaben übernehmen, die seine Speicherkapazität nicht benötigen.
Der Grund, einen 128-GB-Knoten hinzuzufügen, ist nicht:
„Mein Cluster hat jetzt weitere 128 GB gepoolten RAM.“
Sondern:
„Mein Cluster verfügt jetzt über einen weiteren Knoten, der einen speicherintensiven Workload unabhängig ausführen kann.“
Einen tieferen Vergleich dieses Prozessors mit High-Memory-Alternativen finden Sie im Ryzen AI Max+ 395 vs PRO 495 Vergleich.

ACEMAGIC M1A PRO+ 395 — High-Memory KI-Knoten
ACEMAGIC G3A Workstation — NVIDIA-/CUDA-Knoten
Der G3A füllt eine andere Rolle.
Seine relevante Konfiguration kombiniert:
- Core i9-13900F
- NVIDIA RTX 2000 Ada
- 16 GB GDDR6 VRAM
- erweiterbarer Systemspeicher
- kabelgebundene Ethernet-Anbindung
Der wichtige Unterschied ist die NVIDIA-GPU.
Viele KI-Bibliotheken, Entwicklungsumgebungen und Beschleunigungspfade hängen noch stark von CUDA ab.
Das bedeutet, dass ein G3A-Knoten einen High-Memory-AMD-Knoten ergänzen kann, anstatt ihn zu duplizieren.
Beispiel:
M1A PRO+
→ speicherintensives LLM
G3A
→ CUDA-abhängiger Workload
Dies veranschaulicht einen wichtigen Grundsatz für heterogene Cluster:
Der nützlichste zweite Knoten ist nicht immer eine Kopie des ersten.
Manchmal ist ein Knoten mit einer zusätzlichen Fähigkeit sinnvoller als ein weiterer Knoten mit nahezu identischer Hardware.

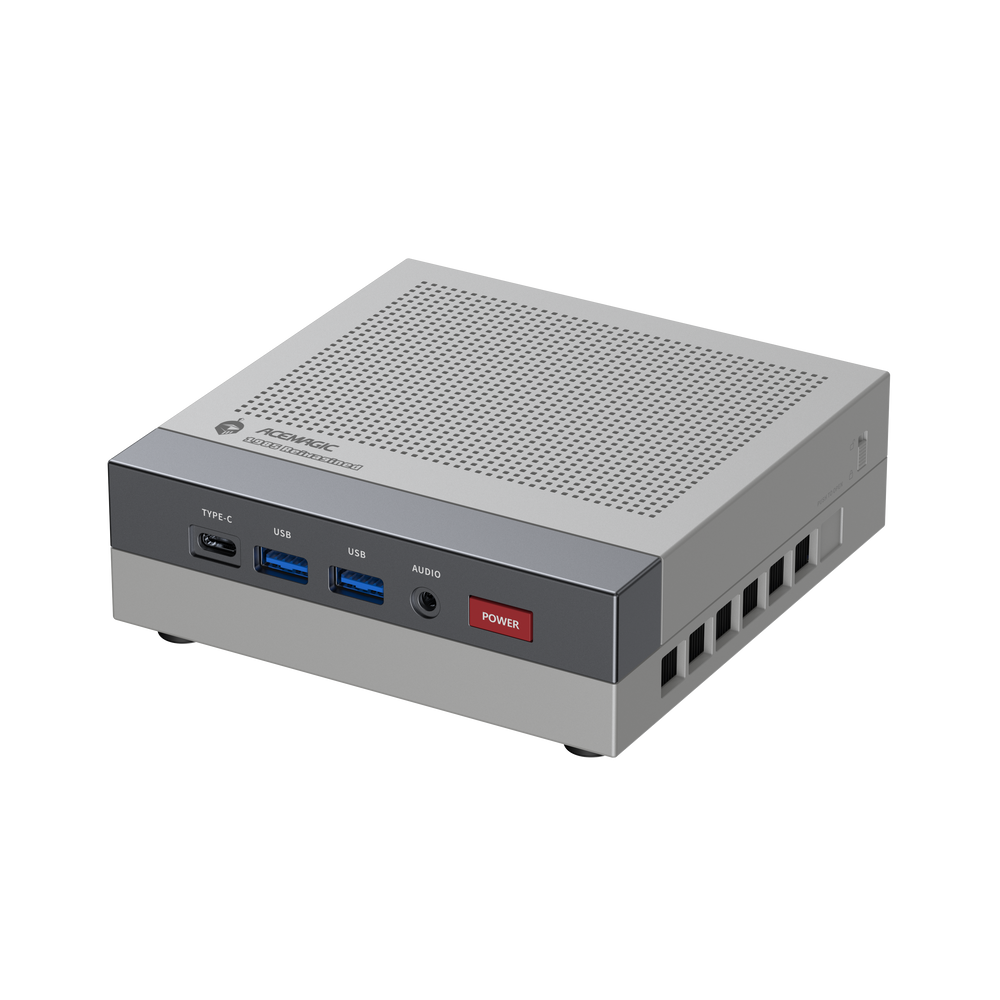
ACEMAGIC G3A — NVIDIA CUDA-Knoten
ACEMAGIC AM18 — Ein praktischer Unterstützungsknoten
In einem realen Setup für lokale KI kann ein AM18 als Unterstützungsknoten dienen, anstatt an jeder Runde der Haupt-LLM-Inferenz teilzunehmen.
Der Cluster könnte beispielsweise wie folgt organisiert werden:
- M1A PRO+ 395: führt das haupspezifische lokale LLM aus, das speicherintensiv ist.
- G3A: bearbeitet Workloads, die NVIDIA CUDA benötigen.
- AM18: führt Unterstützungsdienste wie Embeddings, RAG-Indizierung, Dokumentenverarbeitung, Vektordatenbank-Dienste oder Automatisierung aus.
| Lokaler KI-Cluster | ||
| ¦ | ||
| M1A PRO+ 395 | G3A | AM18 |
| High-Memory-Knoten | RTX 2000 Ada | Unterstützungsknoten |
| Haupt-LLM | CUDA-Aufgaben | RAG / Dienste |
| ¦ | ||
| └───────────────┬──────────────┘ | ||
| 2,5-GbE LAN | ||
Alle drei Systeme bleiben getrennte Computer und kommunizieren über das lokale Netzwerk. In einem RAG-Workflow kann beispielsweise der AM18 die Dokumentenabfrage und Vektorsuche übernehmen, während der M1A PRO+ 395 die finale LLM-Generierung durchführt.
Der AM18 ist daher ein Beispiel dafür, wie ein Unterstützungsknoten in einem heterogenen Cluster eingesetzt werden kann. Für diese Workloads ist nicht zwingend ein AM18 erforderlich; andere Mini-PCs oder Server können dieselbe Rolle übernehmen, abhängig vom Software-Stack und Workload.

ACEMAGIC AM18 — Erweiterbarer Unterstützungsknoten
Wie diese drei Knoten zusammenarbeiten könnten
Ein praktischer heterogener KI-Mini-PC-Cluster könnte so aussehen:
Der wichtige Punkt ist, dass diese drei Systeme nicht zu einem Computer werden.
Sie bleiben getrennte KI-Knoten.
Der Mehrwert entsteht dadurch, dass verschiedene KI-Workloads auf der jeweils am besten geeigneten Hardware ausgeführt werden.
Für viele Nutzer lokaler KI ist diese Art der Workload-Trennung praktischer, als zu versuchen, jeden Knoten an jeder Inferenz-Anfrage zu beteiligen.
Für Nutzer, die an virtualisierungsbasiertem Cluster-Management interessiert sind, behandelt der Proxmox Mini-PC Guide geeignete Systeme für Homelab und Container-Workloads.
Was ist der Hauptnachteil eines Multi-Mini-PC-KI-Clusters?
Mehr Knoten bedeuten auch mehr Overhead.
Im Vergleich zu einem leistungsstarken System bedeutet ein Multi-Knoten-Cluster generell:
- höherer Gesamtstromverbrauch
- mehr Betriebssysteme und Softwareumgebungen zu warten
- höherer Aufwand für konsistente Softwareversionen
- stärkere Abhängigkeit vom Netzwerk
- mehr potenzielle Fehlerquellen
- mehr Zeitaufwand für Monitoring und Fehlerbehebung
Ein zweiter oder dritter Knoten muss also ein echtes Problem lösen.
Wenn ein High-Memory-Mini-PC den gesamten Workload bereits problemlos bewältigt, kann zusätzliche Hardware einfach die Komplexität erhöhen.
Deshalb ist das beste Cluster-Design oft nicht das mit den meisten Knoten.
Es ist das mit den wenigsten Knoten, die erforderlich sind, um die Workloads zu trennen, die tatsächlich um Ressourcen konkurrieren.
Wie man einen Mini-PC-Cluster für lokale KI aufbaut
Starten Sie mit einem Knoten.
Führen Sie den Workload aus, der Sie wirklich interessiert, und identifizieren Sie den Engpass.

Messen Sie Dinge wie:
- Speichernutzung
- TTFT
- Token-Generierungsgeschwindigkeit
- Anfrage-Warteschlangen
- GPU-Auslastung
- CPU-Auslastung
- Konkurrenz durch Hintergrund-Workloads
Entscheiden Sie dann, was der zweite Knoten lösen muss.
Wenn mehrere unabhängige Anfragen warten
Verwenden Sie Workload-Routing.
Lagern Sie unabhängige Agenten oder Modelle auf separate Knoten aus.
Wenn Hintergrund-KI-Workloads die interaktive Inferenz verlangsamen
Lagern Sie Embeddings, Indizierung oder Automatisierung auf einen Unterstützungsknoten aus.
Wenn Sie einen Software-Stack benötigen, der CUDA erfordert
Fügen Sie einen kompatiblen NVIDIA-Knoten hinzu.
Wenn ein Modell einfach nicht passt
Vergleichen Sie zunächst Kosten und Komplexität eines High-Memory-Einzelknotens mit einem verteilten Inferenz-Setup.
Wählen Sie verteilte Inferenz nur, wenn das größere Modell die zusätzliche Netzwerk- und Software-Komplexität rechtfertigt.
Testen Sie schließlich zwei Knoten, bevor Sie drei oder vier hinzufügen.
Wenn Knoten B keinen messbaren Engpass von Knoten A beseitigt, wird ein dritter Knoten die grundlegende Architektur wahrscheinlich ebenfalls nicht verbessern.
Lohnt sich ein lokaler LLM-Cluster?
Ein LLM-Cluster kann besonders dann sinnvoll sein, wenn mehrere Rechner unterschiedliche Aufgaben übernehmen oder ein einzelner Knoten nicht genügend Ressourcen bereitstellt. Wer ein LLM lokal betreiben möchte und dabei mehrere Modelle parallel nutzt, kann von verteilten Ressourcen profitieren.
Gute Beispiele sind:
- Multi-Agenten-Workflows
- mehrere gleichzeitige Nutzer
- verschiedene Modelle für verschiedene Zwecke
- CUDA-Workloads neben High-Memory-Workloads
- Embeddings und RAG-Verarbeitung parallel zur interaktiven Inferenz
- Experimente mit verteilter Inferenz
Weniger sinnvoll ist ein Cluster, wenn Ihr gesamter Workload lediglich aus Folgendem besteht:
ein Nutzer + ein Modell + eine Anfrage gleichzeitig
insbesondere wenn dieses Modell bereits bequem auf einem Knoten passt.
Und wenn Ihr einziges Ziel darin besteht, ein Modell auszuführen, das größer ist als jeder einzelne Knoten fassen kann, bedenken Sie, dass Sie sich von normalem Workload-Routing zur verteilten Inferenz bewegen.
Das verändert das Problem.
Nun sind Netzwerkleistung, Modellpartitionierung und Framework-Unterstützung neben CPU, GPU und Speicher wichtig.
Die Kernunterscheidung ist einfach:
Ein Mini-PC-Cluster macht nicht automatisch aus mehreren kleinen Computern einen großen Computer.
Sein echter Wert liegt darin, Ihnen Kontrolle darüber zu geben, wo jeder KI-Workload läuft — und, wenn verteilte Inferenz tatsächlich notwendig ist, zu entscheiden, ob die zusätzliche Komplexität die größere Modellkapazität wert ist.
Für weitere Hintergründe zum Vergleich von Hardware-Optionen für lokale KI behandelt der DGX Spark vs Strix Halo Vergleich alternative Hardware-Ansätze.
FAQ
Kann man mehrere Mini-PCs für KI clustern?
Ja. Mehrere Mini-PCs für KI können als separate KI-Knoten für verschiedene Modelle, Agenten oder Inferenz-Anfragen arbeiten. Einige Frameworks können auch ein Modell über mehrere Knoten verteilen, was jedoch spezifische Software-Unterstützung erfordert.
Bieten zwei 128-GB-Mini-PCs zusammen 256 GB RAM für ein LLM?
Nicht automatisch. Jeder Knoten behält seinen eigenen Speicher. Workload-Routing-Systeme fassen keinen Speicher zwischen Knoten zusammen. Verteilte Inferenz kann Modelldaten über mehrere Knoten verteilen, aber dies ist nicht gleichbedeutend mit einem nativen 256-GB-Speichersystem.
Reicht 2,5-Gbit-Ethernet für einen Mini-PC-KI-Cluster?
Für Workload-Routing, APIs und viele Homelab-Workloads kann 2,5-Gbit-Ethernet ein praktischer Ausgangspunkt sein. Verteilte Inferenz kann das Netzwerk deutlich stärker belasten, sodass höhere Bandbreite und geringere Latenz wichtiger werden.
Können zwei PCs ein LLM gemeinsam ausführen?
Ja, wenn die Software verteilte Inferenz oder Remote-Compute unterstützt. LLM auf mehreren PCs auszuführen bringt jedoch in der Regel mehr Netzwerk- und Kommunikations-Overhead mit sich als die Ausführung des kompletten Modells auf einem ausreichend großen Knoten.
Brauchen alle KI-Cluster-Knoten dieselbe Hardware?
Nein. Ein heterogener KI-Cluster kann High-Memory-Knoten, NVIDIA-GPU-Knoten und günstigere Unterstützungssysteme kombinieren. Angleichung der Hardware wird wichtiger, wenn mehrere Knoten bei derselben Inferenz-Aufgabe eng zusammenarbeiten müssen.
Was ist der Hauptnachteil eines Multi-Mini-PC-KI-Clusters?
Die wichtigsten Kompromisse sind höherer Gesamtstromverbrauch, mehr Wartungsaufwand, stärkere Netzwerkabhängigkeit und zusätzliche Software-Komplexität. Wenn ein leistungsstarker Knoten den Workload bereits komfortabel bewältigt, kann ein Cluster mehr Komplexität als nützliche Leistung hinzufügen.